DeepSeek-R1 现已上线

DeepSeek
探索未至之境

深度求索新一代逻辑推理通用基座。凭借冷启动大规模纯强化学习突破,带来跨维度的思维链展开与 128k 超长推演能力。欢迎访问 DeepSeek官网 直达 DeepSeek网页版入口,或通过 DeepSeek api开放平台 构筑属于未来的人工智能系统。

  • ✓ 完全免登录快速试用
  • ✓ OpenAI 接口无缝迁移兼容
  • ✓ DeepSeek Harness 基准测试验证
deepseek-r1-inference-preview.sh
128k Context Active
请用 Python 实现高并发下基于自适应退避的 DeepSeek API 令牌桶限流算法,并解释设计考量。
⚙ 深度思考思维链 (已耗时 12 秒)
用户需要高并发场景的令牌桶算法实现,需结合自适应指数退避。首先需确保线程安全与细粒度锁优化,其次计算 Token 阶梯消耗率,并在超出 QPS 阈值时自动平滑回退,与 DeepSeek api开放平台 接口规格对齐。
以下为基于 asyncio 与原子计数的高并发限流实现方案,支持毫秒级平滑令牌注入与网络抖动自适应恢复:
import asyncio, time
class AdaptiveTokenBucket:
  def __init__(self, capacity: int, refill_rate: float):
    self.capacity = capacity
    self.tokens = capacity
    self.last_update = time.monotonic()

自研基座模型核心能力演进

依托纯强化学习与大规模合成数据冷启动,DeepSeek 突破了传统预训练大语言模型在多步推理、长程定理证明与算法推导方面的天花板。以下说明为开发者呈现其四大底层核心支撑体系。

#01
DeepSeek 强化学习自主推理与长程思维链展开架构图

长程思维链与自主反思推演

在面对前沿数理计算与复杂代码竞赛题时,DeepSeek-R1 能够在输出最终结论前生成数万词级的内部思考过程。自主识别错误分支并执行动态回溯修复。
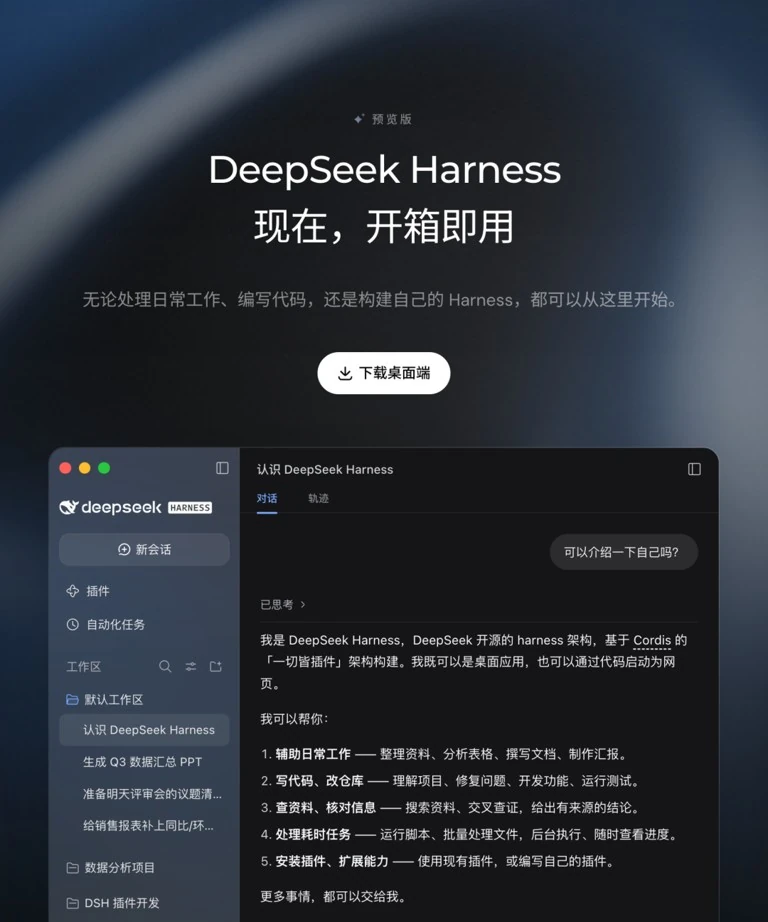
DeepSeek-R1 推理特化版引擎
#02
DeepSeek 128k 超大上下文窗口与多轮文档分析

128k 完整原生超大上下文

采用稀疏注意力(MLA)机制与优化的 RoPE 旋转位置编码,单次会话可无损检索并深入推演超过 30 万字的技术规范、财报或跨工程源文件仓库。
海量代码库与研报穿透解析
#03
DeepSeek MoE 架构与低开销推理基座

MoE 混合专家高能效架构

总参数规模达 6710 亿,每个 Token 仅激活 370 亿参数。以极低算力消耗实现超越同级别稠密模型的运算性能,大幅降低终端使用成本与响应时延。
高吞吐低延迟生产级部署保障
#04
DeepSeek Harness 基准测试框架与自动化评估系统

DeepSeek Harness 严苛基准

配套全开源自动化评估框架,在 GSM8K、MATH-500、Codeforces 及 AIME 国际顶级学术评测中提供全维度可复现验证,确保算法指标真实可靠。

标准评测环境与指标完全透明

权威评测与传统大模型关键维度对比

基于独立复现标准基准环境,展示 DeepSeek-R1 与主流传统大模型在推理准确率、长文本保留率及综合成本控制上的工程演进说明。

核心对比维度 传统预训练通用大模型 DeepSeek-R1 (深度求索最新版) 性能与效率变化
MATH-500 高等数学推导 79.8% (基于固定单步回答) 97.3% (动态思维链多步推演) +17.5% 跃迁
AIME 2024 竞赛级逻辑测试 39.6% (常出现死循环幻觉) 79.8% (支持自我反思与假设推倒) 提升超 100%
Codeforces 算法竞赛排位 百分位 65% (无法处理复杂状态机) 百分位 96.3% (超越绝大多数人类选手) 排位达 Expert 级
长文本大海捞针 (128k Needle) 82.4% (窗口后半段注意力衰减) 99.9% (全上下文均匀注意力激活) 近乎 0 丢失率
百万人群 Token 推理总成本 约 ¥120.00 / 100万 Token ¥2.00 - ¥8.00 / 100万 Token 成本骤降 90%+

高价值工程与研究落地场景说明

从学术前沿推导到工业级分布式架构演进,DeepSeek 的长程推导体系已经深入落地于各类对计算精度有着极高要求的专业领域。

01

高阶算法竞赛与底层代码重构

自主分析千行级遗留 C++/Rust 系统代码,解析多线程死锁风险,重写复杂动态规划与图论算法并附带详尽单元测试用例。

02

金融衍生品逻辑推导与研报穿透

依托 128k 超大上下文,快速提取上百页季度财报数据表,构建跨期对冲数理公式推导并生成带有严密逻辑链条的投资研判。

03

前沿数理科研定理机器辅助证明

面向拓扑学、微分几何与量子信息理论,通过多路径探索推演潜在命题引理,输出标准 LaTeX 格式数学推导全过程。

04

全天候企业内部私有知识库审计

结合本地模型私有化部署规范,穿透企业法务合同、专利合规与工程日志,支持全闭环零外泄的高敏数据深度分析。

05

全自动化 AI Agent 智能协同体

精准支持 Function Calling 与多轮工具调用,在自主规划任务、API 参数矫正与复杂环境探索中展现稳健鲁棒性。

06

跨语言多模态技术文献同声精译

深入理解跨学科专用术语上下文含义,消除生硬机翻错漏,生成符合顶级学术期刊审稿规范的流利论文与技术说明。

深度求索矩阵化模型交付方案说明

针对不同算力预算、网络安全边界与业务吞吐需求,DeepSeek 构建了从轻量蒸馏到万亿集群的全栈模型体系说明。

DeepSeek-V3

通用对话与多任务理解主力基座,高性价比处理日常创作与信息总结。

  • ✓ 671B MoE 架构全面开源
  • ✓ 极速首字输出时延
  • ✓ 128k 超大上下文支持
旗舰推荐
DeepSeek-R1 满血版

面向极高难度复杂逻辑与数学竞赛,自带完备思维链展开与自我反思系统。

  • ✓ 纯强化学习冷启动突破
  • ✓ MATH-500 超高准确率
  • ✓ 官方 API 及网页端直接接入
DeepSeek-R1 蒸馏端侧版

通过优质推理轨迹蒸馏至 1.5B/7B/14B/32B/70B 尺寸,适配本地消费级硬件。

  • ✓ 单张 RTX 4090 即可流畅运行
  • ✓ Ollama 与 LM Studio 原生支持
  • ✓ 离线数据 100% 本地留存
私有集群专有部署方案

面向大型企业客户提供专属算力切片、企业级高可用灾备与定制领域精调支持。

  • ✓ 独享千万 QPS 吞吐集群
  • ✓ 专属 SLA 99.99% 服务协议
  • ✓ 源码级工程调优技术团队常驻

全透明 Token 阶梯与接入规格说明

无需复杂的套路或捆绑预付,DeepSeek api开放平台 坚持行业良心价,以颠覆性成本推动真正人人可用的前沿通用人工智能。

社区免费体验版
面向广大个人学习者与研究人员快速试用
¥0.00
永久免费提供基础额度
  • ✓ DeepSeek网页版免登录对话
  • ✓ 支持 DeepSeek-V3 基础推理
  • ✓ 社区问答与官方文档查阅
  • ✓ 基础并发响应速率
企业私有专享版
面向中大型组织的高吞吐专线与定制部署
专属定制
按需签订年付或私有算力席位
  • ✓ 独享高并发 GPU 算力通道
  • ✓ 7×24 小时专属架构师支持团队
  • ✓ 数据本地化物理隔离与合规支持
  • ✓ 提供金融/医疗领域模型微调服务

DeepSeek API 开放平台极简集成说明

一行代码无缝接入。API 完全兼容 OpenAI 官方 SDK 规范,开发者无需重写现有业务逻辑,仅需更改 Base URL 和 API Key 即可享受数十倍成本红利。

01

OpenAI SDK 零成本平滑迁移

全面支持标准 Chat Completion 接口规范,只需替换环境变量中的 OPENAI_BASE_URL 即可无缝切换现存代理应用。

02

流式思维链原生返回支持

在推理模式下提供独立的 `reasoning_content` 数据字段,方便前端开发者独立渲染可折叠思考过程气泡。

03

高可用全球分布式网关节点

全国多地边缘节点部署,动态负载均衡保证 99.9% 以上服务可用性,具备极速冷启动响应优势。

python_sdk_integration.py HTTP 200 OK
# 兼容标准 OpenAI 客户端库集成 DeepSeek 接口
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com"  # 官方接口基地址
)

response = client.chat.completions.create(
    model="deepseek-reasoner",  # DeepSeek-R1 深度推理引擎
    messages=[
        {"role": "user", "content": "推导黎曼猜想关于非平凡零点分布的关键引理"}
    ],
    stream=True
)

for chunk in response:
    # 提取思维链过程与最终结论
    if hasattr(chunk.choices[0].delta, 'reasoning_content'):
        print(chunk.choices[0].delta.reasoning_content, end="")
    if hasattr(chunk.choices[0].delta, 'content'):
        print(chunk.choices[0].delta.content, end="")

全平台客户端与应用矩阵说明

随时随地连接深度求索云端算力。无论在桌面系统多任务工作区还是移动终端碎屏推导,DeepSeek 提供统一的交互质感与历史记录同步说明。
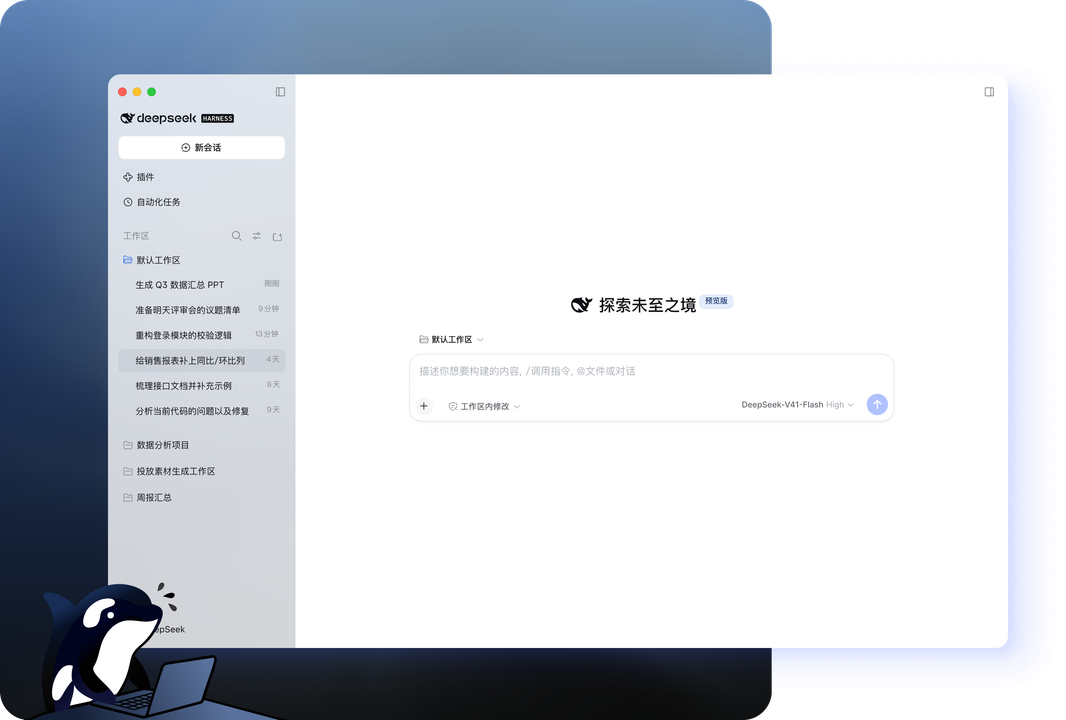
DeepSeek 全平台客户端运行预览与多端会话同步展示
W

Windows 桌面客户端

适配 Windows 10/11,支持系统级快捷键唤醒与本地代码沙箱

获取安装包
M

macOS 纯净版客户端

针对 Apple Silicon 芯片深度架构优化,高帧率流畅运行

DMG 格式下载
i

iOS & iPadOS 移动端

支持随航触控推演与即时语音输入转思维链

App Store
A

Android 官方客户端

主流移动处理器自适应降噪排版与多文档长文本批注

APK / 应用商店
671B
总参数规模架构突破
128K
原生完整超长上下文推演
97.3%
MATH-500 严苛数学基准
100%
核心模型权重与论文开源

来自前沿科研与工程团队的使用反馈说明

听听全球第一梯队技术团队在实际生产线与学术研究中,如何将 DeepSeek 融入日常工作流中的真实说明。

“
DeepSeek-R1 的纯强化学习冷启动推演路径颠覆了我们对 LLM 机械背诵的固有认知。在定理辅助证明过程中,它展现出的回溯自我纠偏逻辑令人震撼。
张博士 高校应用数学研究所首席研究员 使用方式:深度数理引理机器推导
“
我们将全链路海外 API 迁移至 DeepSeek api开放平台 后,每月 Token 账单直接节省了近八成,同时代码审查与重构准确率反而有了肉眼可见的提高。
Alex Chen 硅谷出海软件团队技术总监 使用方式:微服务架构自动化重构
“
在日常分析长达数百页的上市招股说明书时,DeepSeek网页版入口 的 128k 上下文表现得极为稳健,不再发生传统大模型前后矛盾的幻觉现象。
李女士 量化投资机构高级合规总监 使用方式:高敏财报多文档穿透审计

围绕 DeepSeek 核心问题权威解答说明

为您整理了关于网页版访问方式、API 接入规则、算力配置及本地私有化部署说明。

DeepSeek 网页版入口与 API 开放平台支持免费使用吗? +
是的。用户通过本站提供的 DeepSeek网页版入口 可以直接体验基础模型对话与高阶推理功能。对于开发者,DeepSeek api开放平台 在注册阶段提供足额免费测试 Token,商业化调用计费标准同样处于全球最低区间(每百万 Token 仅需 ¥2.00 起),极具普惠性。
DeepSeek-R1 与 DeepSeek-V3 的技术区别在哪里? +
DeepSeek-V3 是采用 MoE 架构的高性能通用大模型,适合广泛的写作、翻译、通用问答与多轮任务交互;而 DeepSeek-R1 则是专注于强化学习与推理思考的前沿特化大模型,在回答前会展现完整的内部思维链,在数学推演、算法逻辑证明及复杂代码调试中具备显著优势。
什么是 DeepSeek Harness 基准测试框架?如何进行复现? +
DeepSeek Harness 是深度求索官方开源的基准评估流水线套件,包含对 GSM8K、MATH-500、HumanEval 等核心学术榜单的自动化校验脚本。所有测试用例、评测环境隔离容器与复现命令均已完全公开,开发者可根据帮助中心的指引在本地进行权威复现验证。
个人开发者能否在本地单张消费级显卡上部署运行? +
完全可以。深度求索官方开源了基于 DeepSeek-R1 优质推理数据蒸馏而成的系列轻量化模型(涵盖 1.5B、7B、8B、14B、32B 和 70B 尺寸)。利用 Ollama、vLLM 或 llama.cpp,即使是配备 8GB-16GB 显存的普通电脑也能顺畅实现完全离线的本地私有化运行。
现有 OpenAI 格式的业务系统如何无缝迁移接入? +
由于 DeepSeek 官方 API 接口在通信协议、参数结构及鉴权方式上严格兼容标准 OpenAI 规范,现有系统仅需将接口 Base URL 调整为官方地址 `https://api.deepseek.com` 并替换相应的 API Key 即可,无需改动原有的业务调用逻辑与解析组件。

前沿架构技术动向与最新学术成果

及时掌握深度求索在纯强化学习、稀疏注意力机制与大模型高效训练领域的最新论文与技术博文说明。

学术论文发布

DeepSeek-R1 纯强化学习冷启动技术白皮书详解

深度揭秘在零人工监督标注数据先验的前提下,大模型如何通过自主试错机制涌现出长程反思与复杂逻辑验证能力。

2026-10-18 阅读全文 →
工程实践指南

使用 DeepSeek Harness 搭建自动化大模型基准测试环境

一步步手把手指导系统架构师如何在本地私有集群内,快速部署与复现国际一流的推理逻辑评测指标。

2026-10-12 阅读全文 →
API 升级公告

DeepSeek API 开放平台 128k 上下文缓存与计费优化

全新引入上下文缓存(Context Caching)技术,对于高频静态系统提示词与长文档输入,大幅降低 Token 开销。

2026-10-05 阅读全文 →

跨越传统认知边界,与 DeepSeek 携手探索未至之境。

无论是即刻在浏览器中体验思维链的飞跃,还是将千万级推理能力接入您的生产环境,深度求索始终以纯粹的技术追求赋能每一位创造者。